AI 语音合成入门:用 API 让文字开口说话
你有没有想过,让 AI 把一段文字变成自然流畅的语音?无论是制作有声读物、为视频配音,还是搭建语音助手,语音合成(TTS)技术都能帮你实现。本文将手把手教你通过词元圈 API 调用 TTS 服务,零基础也能快速上手。
什么是语音合成
语音合成(Text-to-Speech,简称 TTS)是一种将文字转换为语音的技术。简单来说,你给 AI 一段文字,它就能「读」出来,而且声音越来越接近真人。
现代 TTS 技术已经能做到:
- 自然流畅:不再是机械的电子音,听起来像真人朗读
- 多种音色:男声、女声、不同风格随意选择
- 多语言支持:中文、英文、日语等主流语言都能处理
- 情感表达:可以根据内容调整语调和情感
准备工作
开始之前,你需要准备以下内容:
- 词元圈账号:访问 ciyuano.com/register 注册
- 一个 API 密钥:在后台「API 密钥」页面创建
- 一个 HTTP 客户端:可以用 curl(命令行)、Postman、或者任意编程语言
提示:TTS 功能需要账户有足够余额。新注册用户通常有免费额度,可以在后台「用量」页面查看。
选择合适的音色
词元圈支持多种语音音色,每种音色都有不同的风格特点。以下是常用音色对比:
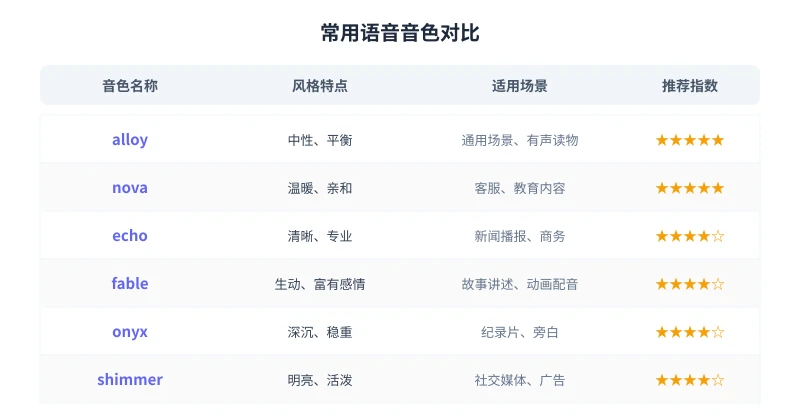
选择音色的建议:
- 不确定用哪个?选
alloy,最通用的中性音色 - 做客服或教育内容?选
nova,温暖亲切 - 做新闻播报?选
echo,清晰专业 - 讲故事或配音?选
fable,富有感情
详细操作步骤
第一步:获取 API 密钥
登录词元圈后台,进入「API 密钥」页面,创建一个新密钥。复制密钥,格式类似 sk-relay-xxxxxxxxxx。
安全提醒:密钥只显示一次,请妥善保存。不要将密钥硬编码在公开的代码仓库中。
第二步:发送 TTS 请求
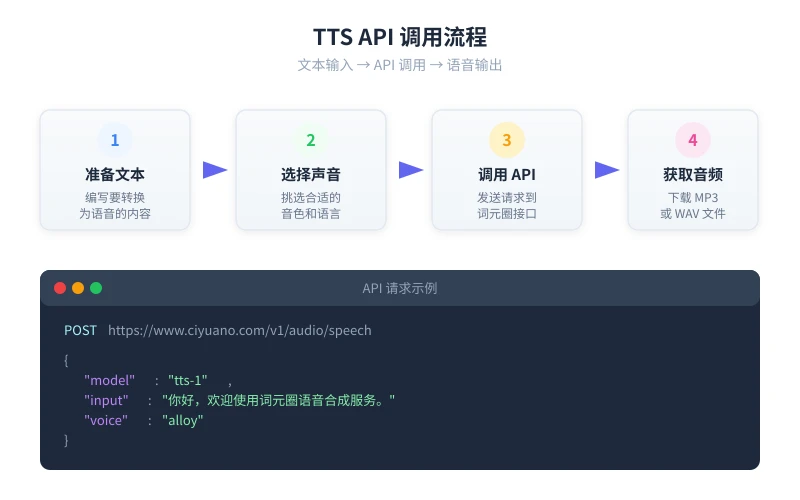
使用 curl 命令发送一个最简单的 TTS 请求:
curl -X POST https://www.ciyuano.com/v1/audio/speech   -H "Authorization: Bearer sk-relay-你的密钥"   -H "Content-Type: application/json"   -d '{
    "model": "tts-1",
    "input": "你好,欢迎使用词元圈语音合成服务。今天天气真不错!",
    "voice": "alloy"
  }'   --output speech.mp3
这条命令的含义:
POST /v1/audio/speech:调用语音合成接口model:使用的模型,tts-1为标准模型,tts-1-hd为高清模型input:要转换为语音的文字内容voice:选择的音色--output speech.mp3:将返回的音频保存为 MP3 文件
执行成功后,当前目录会生成一个 speech.mp3 文件,用任意播放器打开即可听到 AI 生成的语音。
第三步:调整语音参数
你可以通过额外参数来控制语音效果:
{
  "model": "tts-1-hd",
  "input": "这是一段需要高清音质的语音内容。",
  "voice": "nova",
  "speed": 1.2,
  "response_format": "mp3"
}
可调参数说明:
| 参数 | 说明 | 默认值 |
|---|---|---|
model |
模型选择:tts-1(标准)或 tts-1-hd(高清) |
tts-1 |
voice |
音色选择:alloy / nova / echo / fable / onyx / shimmer | alloy |
speed |
语速,范围 0.25 ~ 4.0 | 1.0 |
response_format |
输出格式:mp3 / opus / aac / flac / wav / pcm | mp3 |
小技巧:如果语音速度不合适,用 speed 参数调整。比如听书场景可以用 1.2 ~ 1.5 倍速,讲解场景可以用 0.8 ~ 1.0 倍速。
第四步:在代码中调用
如果你熟悉 Python,可以用以下代码调用 TTS 接口:
import requests

url = "https://www.ciyuano.com/v1/audio/speech"
headers = {
    "Authorization": "Bearer sk-relay-你的密钥",
    "Content-Type": "application/json"
}
data = {
    "model": "tts-1",
    "input": "你好,这是一段测试语音。",
    "voice": "nova"
}

response = requests.post(url, headers=headers, json=data)

with open("output.mp3", "wb") as f:
    f.write(response.content)

print("语音已生成:output.mp3")
JavaScript / Node.js 的调用方式类似:
const response = await fetch("https://www.ciyuano.com/v1/audio/speech", {
  method: "POST",
  headers: {
    "Authorization": "Bearer sk-relay-你的密钥",
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    model: "tts-1",
    input: "你好,这是一段测试语音。",
    voice: "nova"
  })
});

const buffer = await response.arrayBuffer();
require("fs").writeFileSync("output.mp3", Buffer.from(buffer));
console.log("语音已生成:output.mp3");
实用场景示例
场景一:批量生成有声内容
如果你有一批文章需要转成语音,可以写一个简单的循环脚本,逐段调用 TTS 接口。注意控制调用频率,避免触发限流。
场景二:视频配音
制作教程视频时,先用 TTS 生成旁白音频,再用剪辑软件合成到视频中。比自己录音更高效,音质也更稳定。
场景三:语音通知
在应用中加入语音通知功能,比如订单提醒、系统告警等。用户收到的不再是冷冰冰的文字,而是一段温暖的语音提示。
场景四:多语言内容
同一个内容可以用不同语言的音色生成多语言版本,方便做国际化内容分发。
常见问题
| 问题 | 解决方案 |
|---|---|
| 返回 401 错误 | 检查 API 密钥是否正确,是否已过期或被禁用 |
| 返回 429 错误 | 请求过于频繁,降低调用频率或升级套餐 |
| 音频文件为空 | 检查 input 字段是否为空,文字长度是否超过限制 |
| 中文发音不自然 | 尝试切换不同音色,或使用 tts-1-hd 模型获得更好效果 |
| 生成速度慢 | tts-1 比 tts-1-hd 更快;长文本建议分段处理 |
使用技巧
- 文本预处理:去除不必要的特殊字符和格式符号,让语音更自然
- 分段处理:长文本建议按段落或句子拆分,每段不超过 4000 字符
- 格式选择:日常使用选 MP3 即可;需要无损音质选 FLAC 或 WAV
- 缓存复用:相同内容的音频可以缓存,避免重复调用产生额外费用
- 多音色对比:不确定用哪个音色时,先用短文本测试多种音色效果
总结
通过词元圈的 TTS API,你可以轻松将文字转换为自然流畅的语音。整个过程只需要三步:
- 获取 API 密钥
- 发送一个 HTTP POST 请求
- 接收并保存音频文件
下一步:尝试用不同音色朗读同一段文字,感受不同音色的风格差异。然后把它集成到你的项目中,为用户带来更好的语音体验。
相关文章
AI 语音转文字:零基础实操指南,三步把说话变成文字
还在打字到手指发酸?还在为会议记录发愁?AI 语音转文字技术已经非常成熟,学会使用它,可以帮你把说话直接变成文字,效率提升数倍。本文将手把手教你选择工具、完成转写、导出使用,让 AI 成为你的打字替身。
教程指南AI 本地部署入门:零基础三步跑起大模型,完全免费
不用注册、不用充钱、完全离线。本文手把手教你用 Ollama 等工具,在自家电脑上部署运行开源大模型,从零开始完成本地 AI 部署的全过程。
教程指南AI 帮你做购物决策:从比价到避坑的完整实操指南
买手机、买耳机、买电脑,AI 真的能帮你选对吗?本文用五个实操步骤,手把手教你让 AI 完成价格对比、参数解析、口碑筛选和避坑提醒,小白也能 10 分钟搞定购物决策。
评论功能暂未开放,敬请期待